真正有价值的结果是一套可审查的硬件候选实现:它带着实现报告、独立期望数据流、数十亿周期上板记录,以及一份被检查器明确拒绝的故意破坏版本。
“两天”究竟包含什么
计时从 9 月 23 日的任务定义开始。上板回放和反证对照在 28 小时 33 分后闭环,当前证据包在 33 小时 4 分后闭环。期间,流程需要理解 LTE Turbo 结构;在初次生成没有完成 SISO 数据通路后补齐实现;选择资源友好的架构;生成 RTL;完成独立对比;通过布线后时序,并让数据流在硬件上运行。
这是该案例的实际耗时,不是“所有通信 IP 都能两天完成”的承诺。真正可复用的是持续产出证据的流程:一个候选实现不会因为看起来合理就自动毕业。
第一轮并没有完成译码器
Turbo 译码并不适合用表面化的代码生成来证明能力。分量码网格本身并不神秘,但可用实现还要协调前向和后向度量、系统位与校验位观测、QPP 交织、外信息反馈、帧边界和迭代调度。初次生成没有完成 SISO/Turbo 数据通路,随后由架构阶段补齐缺失的数据通路和调度。
流程保留了失败尝试,并把问题从代码语法推进到硬件所有权:什么需要存储、什么可以复用、什么标识当前帧与半迭代,以及哪些状态被允许前进。
关键架构选择是时间复用
六次迭代的直接展开可能暗示十二套半迭代硬件。候选实现让一套 Max-Log-MAP SISO 引擎在十二个半迭代中复用。帧存储器按自然顺序或 QPP 顺序供数,外信息反馈则携带足够的身份,避免阶段或帧之间串扰。
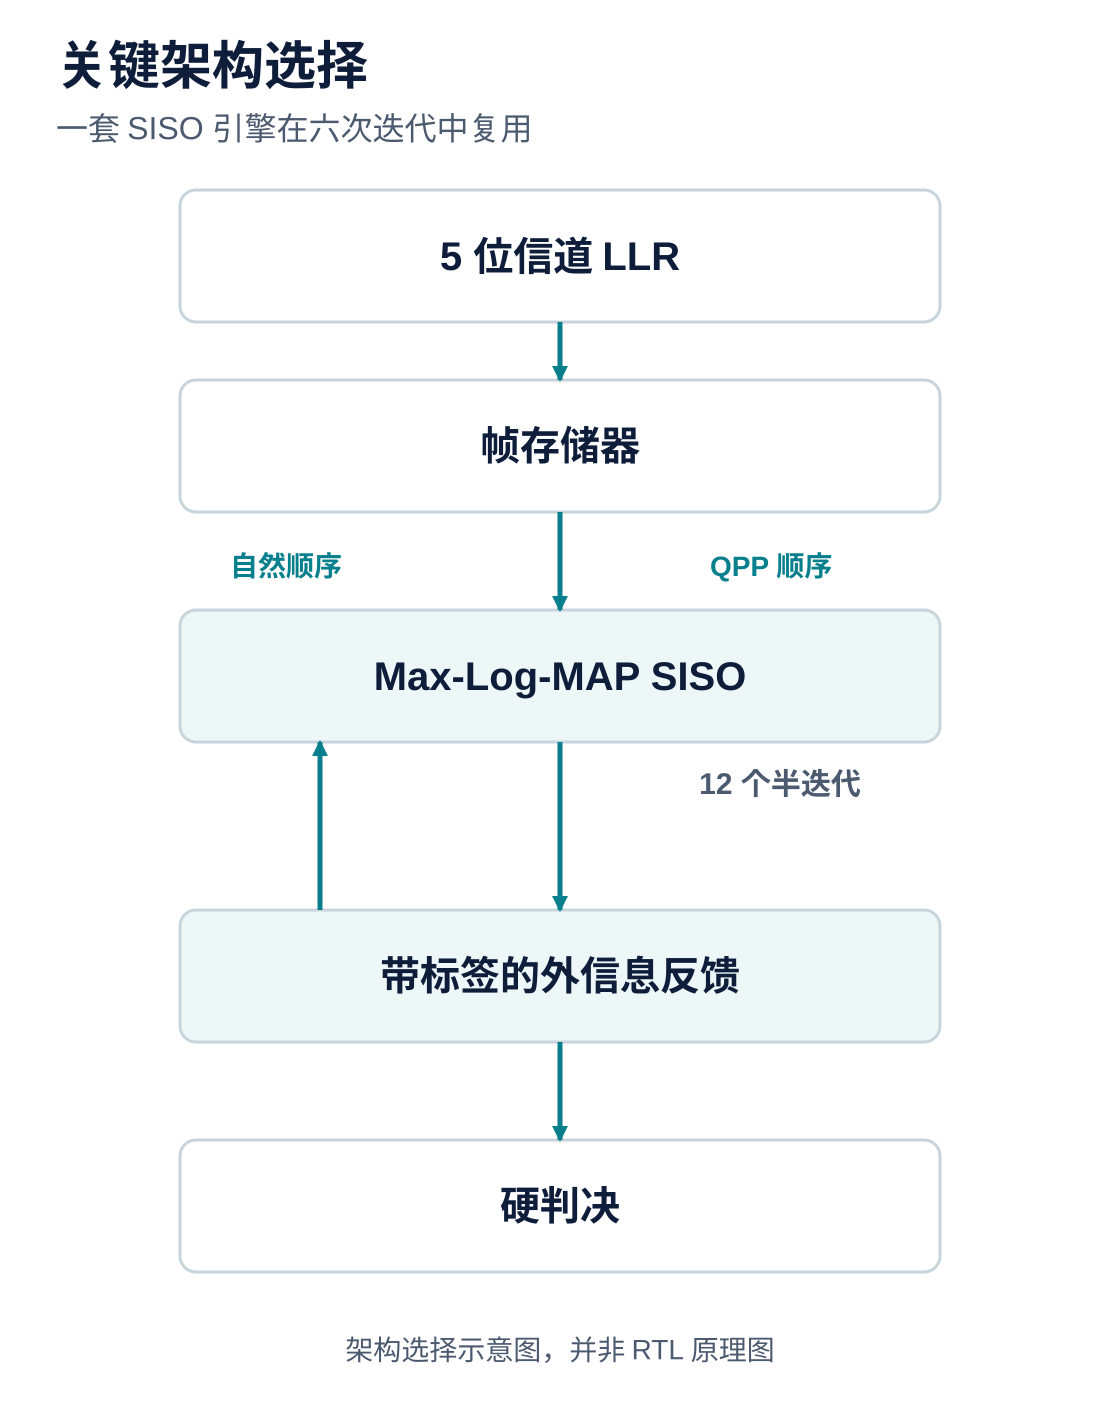
当前实现接受 K=40 到 K=6144 的全部 188 个 LTE QPP 块长。旗舰实测点采用 K=6144、六次迭代、WINDOW=32 和 5 位信道输入。它是一颗译码器核,不宣称包含 CRC、速率匹配、HARQ、分段或完整 LTE 调制解调器。
优化也要保留没有赢的代价
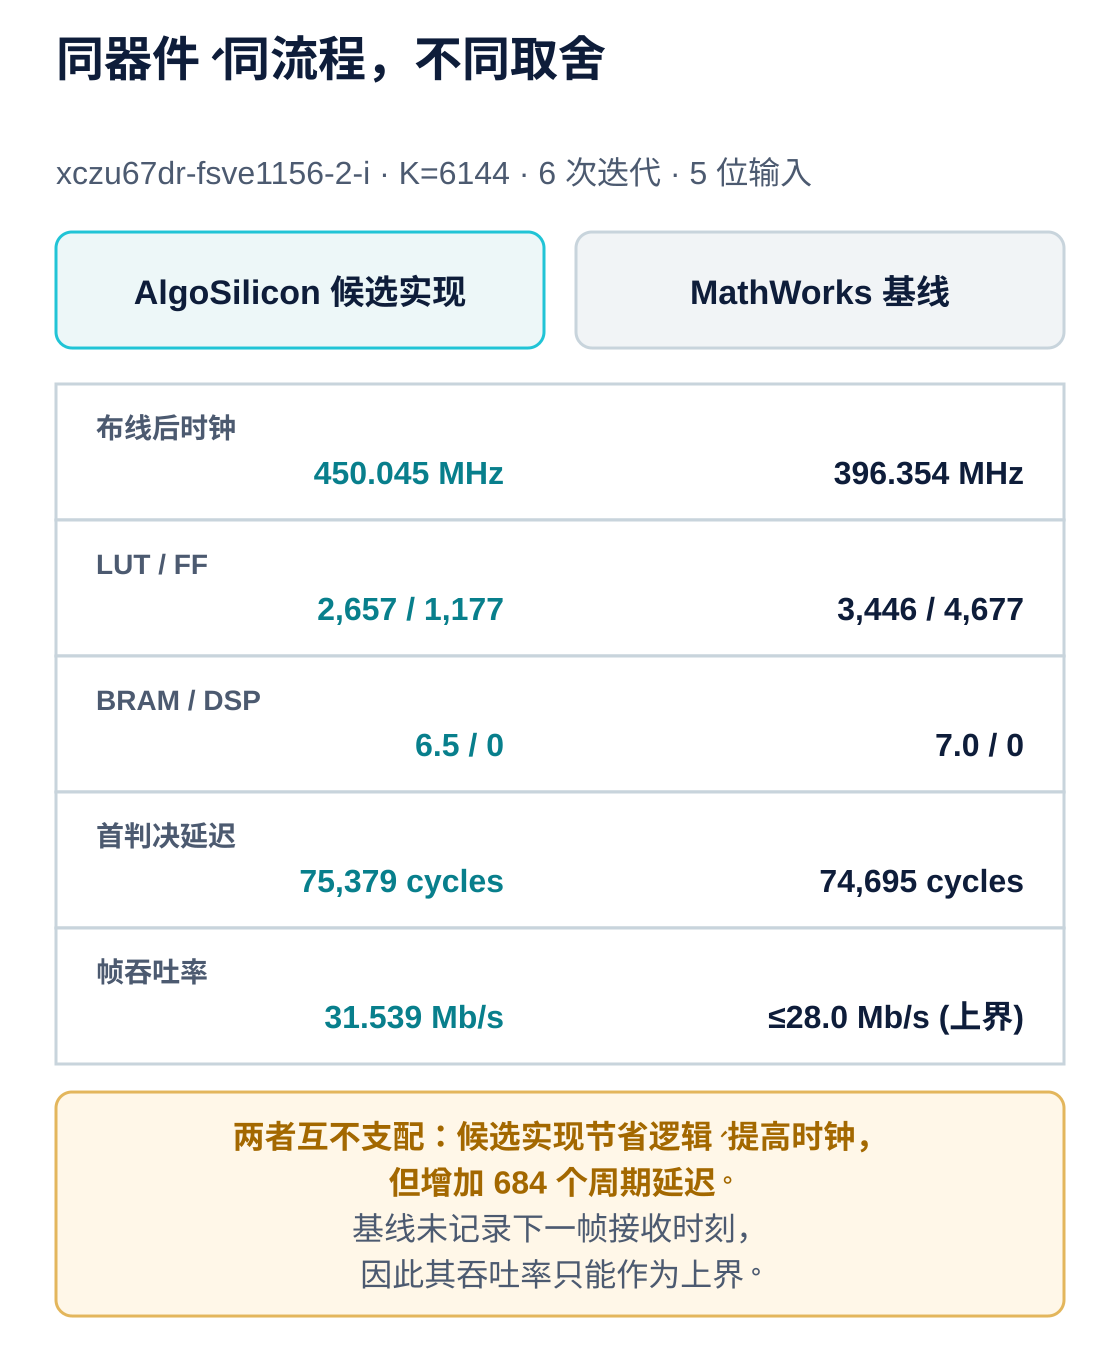
在 xczu67dr-fsve1156-2-i 上,使用相同的离线布局布线流程,候选实现以 2,657 个 LUT、1,177 个触发器、6.5 个 BRAM 和 0 个 DSP 收敛到 450.045 MHz。MathWorks R2026a 基线以 3,446 个 LUT、4,677 个触发器、7.0 个 BRAM 和 0 个 DSP 收敛到 396.354 MHz。
候选实现逻辑和存储更少,时钟更高,但首判决晚了 684 个周期:75,379 对 74,695。这个代价被完整保留。候选实现的实测帧吞吐率是 31.539 Mb/s;由于基线没有记录下一帧接收边界,其 28.0 Mb/s 只能作为上界。诚实结论是:两者互不支配。
验证必须经得住一份故意做坏的设计
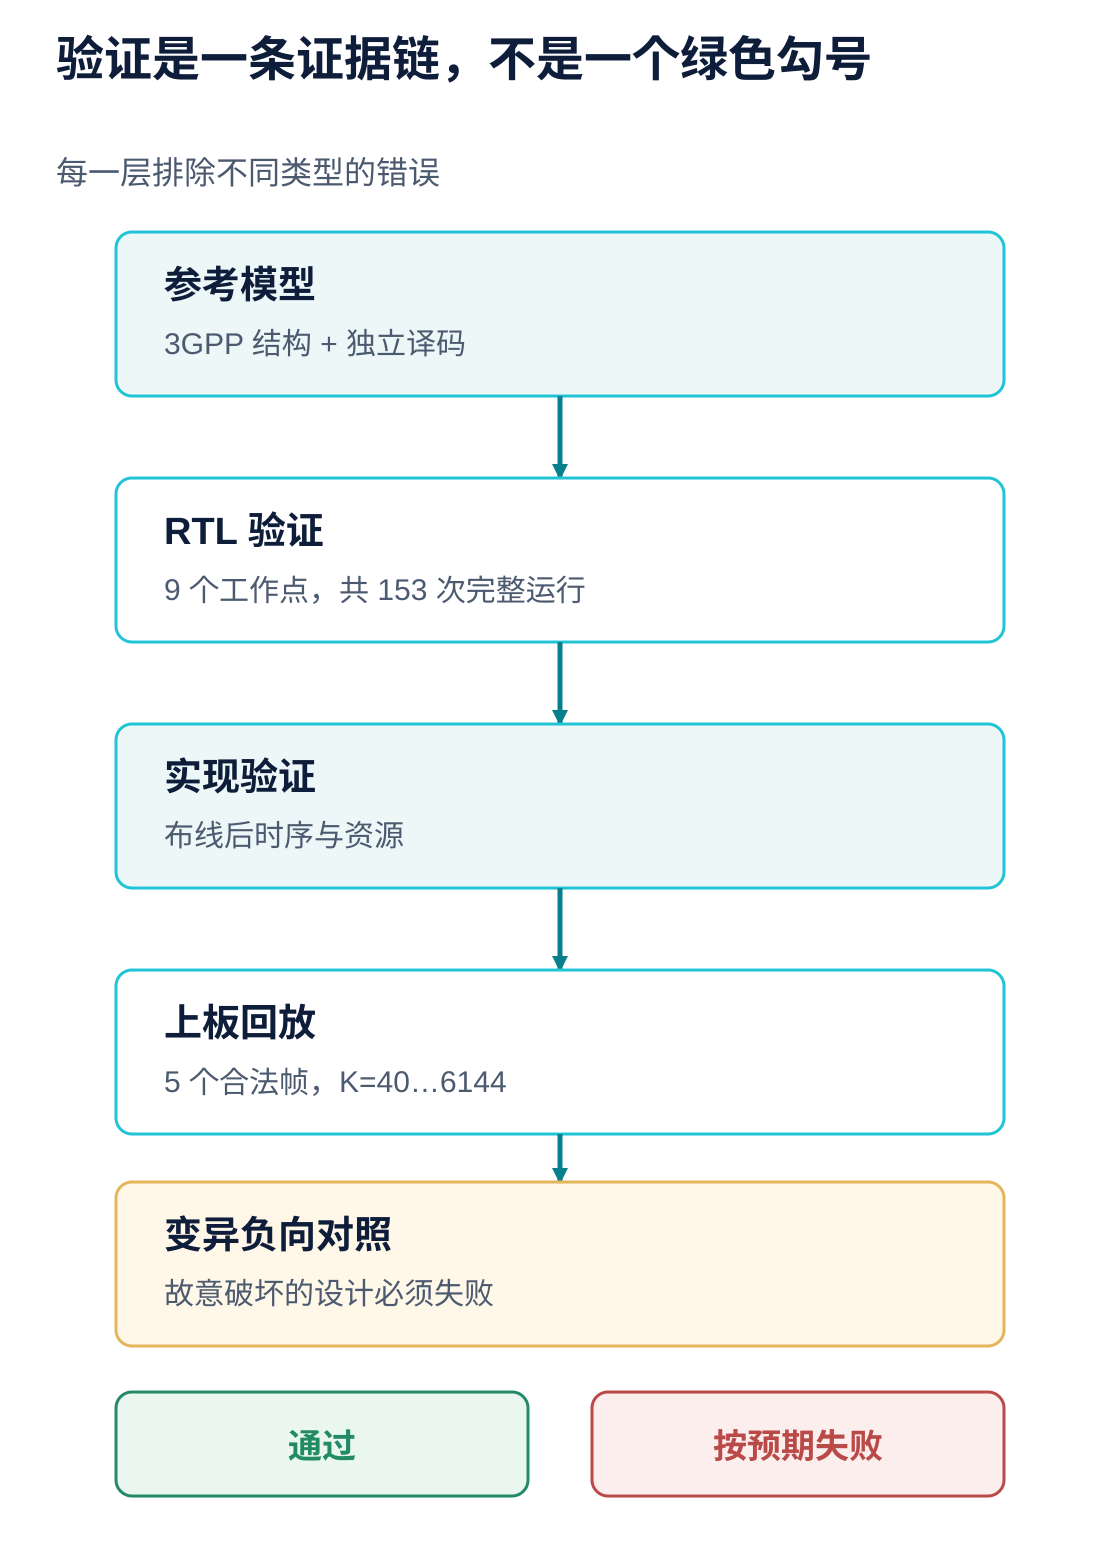
我们分四层检查:独立算法、RTL、布线后实现和上板回放。RTL 记录包含 9 个工作点上的 153 次完整运行;交叉检查覆盖 9 个帧案例和 16,136 个信息位;上板回放覆盖 K=40 到 K=6144 的 5 个合法块长、8,883 个输入字和 8,848 个判决。
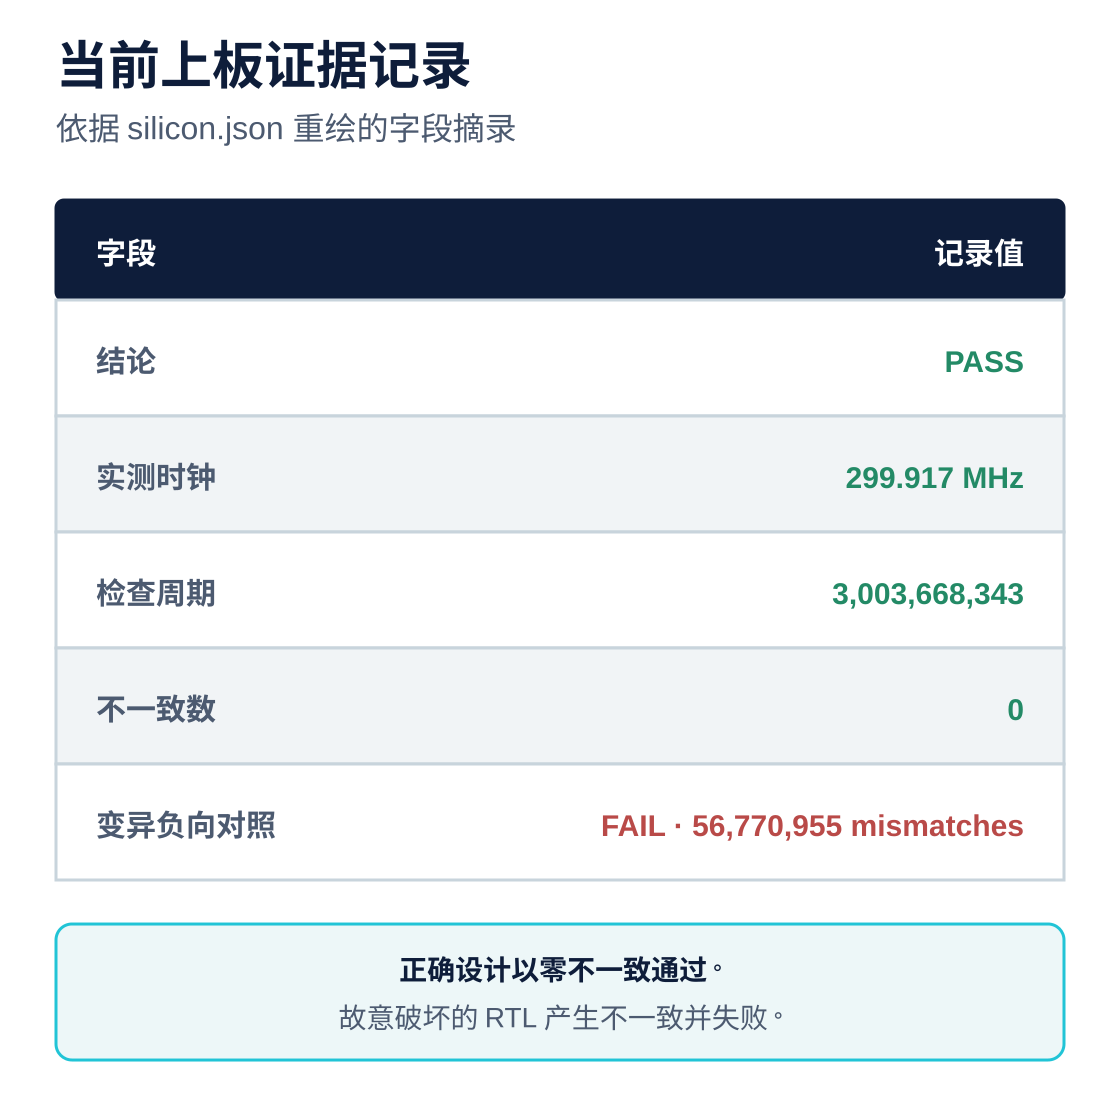
当前上板记录在 299.917 MHz 下运行 3,003,668,343 个周期,零不一致。随后,一处 RTL 条件被故意变异,该版本产生 56,770,955 个不一致并失败。负向对照很重要,因为从未见过已知坏设计的检查器,还没有证明自己能够拒绝错误。
哪些条件已经成熟,哪些仍属于客户评估
这个案例说明,AI 辅助 RTL 工程已经可以足够快地形成“候选实现 + 证据包”,从而支撑通信 IP 的批量化生产流程,而不只是一次性演示。证据包包含参数边界、布线后工作点、明确的同流程比较、模型和 RTL 记录,以及带反证对照的上板结果。
但一个器件和一组负载并不会自动变成普适产品保证。客户交付仍需明确目标器件、接口、吞吐、延迟、信道模型、授权形式和验收负载。正是这些条件决定应该生成、优化和签核哪个工作点。
具体实现数字与评估边界集中在 LTE Turbo 译码器产品页。